当前全球科研创新范式已经全面进入 AI+HPC 科学智能新阶段,大量科研院所的现有计算基础设施已经难以匹配前沿科研工作的发展需要。多数院所仍主要依靠单机工作站和通用服务器开展仿真计算工作,没有建设规模化、全栈国产化的高性能计算集群,面对百万原子体系、杂化泛函、高精度理论计算等复杂科研任务,会出现计算周期漫长,严重拖慢新材料、新工艺研发迭代节奏的现实问题。
现有分散式计算模式下,各个课题组设备相互独立运行,经常出现部分设备长期闲置,而重点科研项目算力争抢的矛盾,整体计算资源综合利用率长期处于较低水平。同时环境缺少低延迟高速互联网络与分布式并行存储底座,大量原生支持多节点并行的仿真软件无法发挥并行加速能力,跨尺度、大体系模拟业务根本无法落地。
与此同时 AI 驱动科学研究已经成为材料、化工等重点领域的主流技术路线,但多数科研院所尚未建成体系化的国产 AI 算力底座,训练与推理集群规模有限,AI 相关工作仅可以完成单机层面小模型调试,大模型从零预训练、全参数微调、批量预测推理等业务均无法落地。
针对以上业务痛点,本方案规划建设国产化超智算融合算力平台,为多学科方向科研创新提供坚实算力底座支撑。
建设一套面向科研业务场景的国产化超智算融合平台,补齐国产化 HPC 高性能集群、国产 AI 智算算力两大核心能力短板,实现高性能科学计算与人工智能算力统一调度,达成算存网一体化协同运行效果。平台需要同时具备大规模 HPC 仿真、高并发 AI 推理、百卡级别分布式 AI 训练、全链路科研数据治理的完整业务能力,打通从仿真计算、AI 模型训练、大模型推理再到数据集加工处理的全科研业务链路,全面满足科研业务自主可控高安全高可靠的建设要求。
传统单机工作站的运行模式无法支撑百万原子体系、杂化泛函高精度计算等大规模仿真工作,业务对多节点 MPI 并行计算能力存在刚性需求。
科研工作普遍存在多尺度耦合仿真的业务诉求,HPC 集群主要负责底层高精度机理数值求解,AI 算力承担分子结构预测结果迭代优化工作,两类异构算力之间需要实现协同调度配合。长周期仿真计算任务容易遇到节点硬件故障、程序异常中断等问题,平台必须具备任务断点续算故障节点自动迁移快照保存能力,避免数周甚至数月的计算任务需要从头重新执行。同时需要配套分层存储架构,分别承载仿真过程临时读写文件、中间轨迹数据以及最终归档结果,解决仿真业务临时文件高 IO 访问、海量历史结果长期归档存储的双重业务诉求。
平台 AI 算力需要覆盖四大类标准化科研业务场景,分别是科研大模型与材料基础模型预训练微调、科研大模型交互式在线推理、高通量离线批量材料预测、AI 代理多尺度耦合仿真。不同业务场景、不同规模的 AI 模型对算力资源的要求差异较大。
平台需要同时配置推理算力与大规模训练算力资源,实现在线推理服务和离线训练任务的共存运行。系统需要完善任务优先级管控策略,保障高优先级在线推理业务的服务质量,同时支持利用业务低谷阶段的空闲算力资源开展模型微调、离线批量预测工作,通过算力潮汐复用手段,进一步提升整套 AI 硬件资源的实际利用率。
科研业务全流程会持续产生大量多模态数据,涵盖仿真输出数值文件、各类试验原始记录、文献文本资料、晶体分子结构文件、红外质谱 XRD 谱图图像等。需要搭建国产化一站式数据加工工作台,覆盖数据接入汇聚清洗处理智能标注质量评估数据集发布资产管理全生命周期流程。
平台需要构建完整的数据资产管控体系,建立标准化标签体系、数据血缘追踪、数据资产目录,实现全院所科研数据资产的可视化统一管理。同时搭建标准化的数据质量评估体系,自动识别过滤低质量异常样本,以此提升 AI 模型训练收敛速度和材料预测结果精度。数据安全层面需要落实全链路管控策略,符合科研数据安全管理的相关规范。
针对如上需求分析,根据超智算中心能力需求,本次超智算中心融合平台总体架构设计如下图所示:
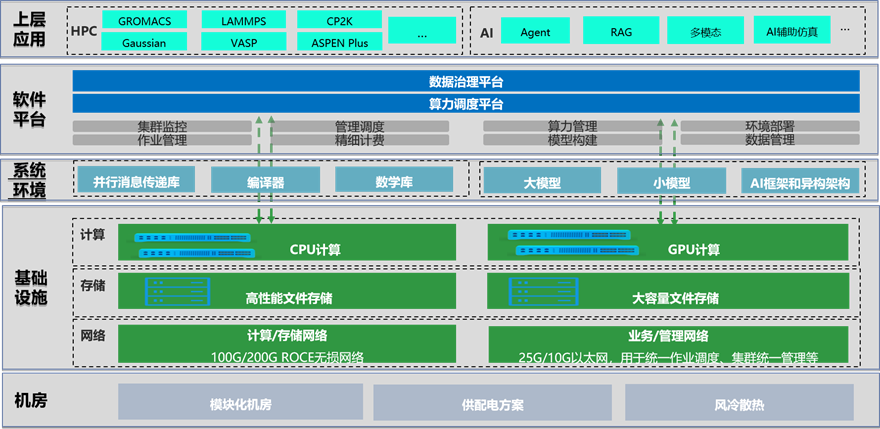
超智算中心融合平台总体架构图
整体采用五层架构自上而下依次搭建:上层应用层、软件平台层、系统环境层、基础设施层、机房环境层,实现 HPC 高性能仿真业务与 AI 人工智能业务深度融合,打破原有工作站、X86 单机的孤立计算模式,构建一套 “国产 CPU‑HPC + 国产GPU‑智算”异构一体化的科学智能算力底座。
1. 上层应用层:划分为 HPC 业务域与 AI 业务域两大板块,是面向科研人员的最终业务访问入口。HPC 业务域部署各类量子化学、分子动力学、化工流程等仿真软件,完成几何优化过渡态搜索大规模分子动力学模拟等机理计算任务,替代传统单机工作站离散计算模式。AI 业务域部署科研智能助手知识库问答多模态识别高通量分子筛选 AI 辅助仿真等上层应用,实现 AI 预测 HPC 高精度验证 AI 迭代优化的新型科研工作范式。
2. 软件平台层:作为整个超智算平台的管理中枢,核心由算力调度平台和数据治理平台两大部分组成。算力调度平台向下对接各类硬件资源,向上承接全部 HPC 和 AI 业务,实现异构算力统一纳管作业任务调度集群状态监控资源计量统计等能力。数据治理平台承担全平台科研数据的全生命周期管控,完成多模态数据采集清洗标注流转权限管控,沉淀结构化与非结构化科研数据资产,为仿真复现模型训练知识库应用提供标准化数据集支撑。
3. 系统环境层:属于硬件与上层业务软件之间的中间适配层,分为 HPC 运行环境和 AI 运行环境。HPC 运行环境部署并行消息传递库编译器数学基础库,完成各类商用开源仿真软件在国产 CPU 硬件之上的编译适配和并行优化。AI 运行环境部署国产深度学习框架大模型推理引擎材料领域专用模型库以及异构硬件适配组件,完成各类科研 AI 模型算子适配,摆脱对海外闭源加速技术的依赖。
4. 基础设施层:包含计算存储网络三大核心模块。计算资源划分为 CPU‑HPC 算力池和 AI 智算算力池,智算算力池同时承载推理业务和大规模分布式训练业务。存储资源分为高性能并行文件存储面向高频访问热数据,大容量归档文件存储面向温冷归档数据。网络系统划分为高速 RDMA 业务存储网络以及管理运维以太网,实现业务流量与管理运维流量物理隔离,避免不同业务之间带宽互相抢占。
物理架构示意图如下图所示:
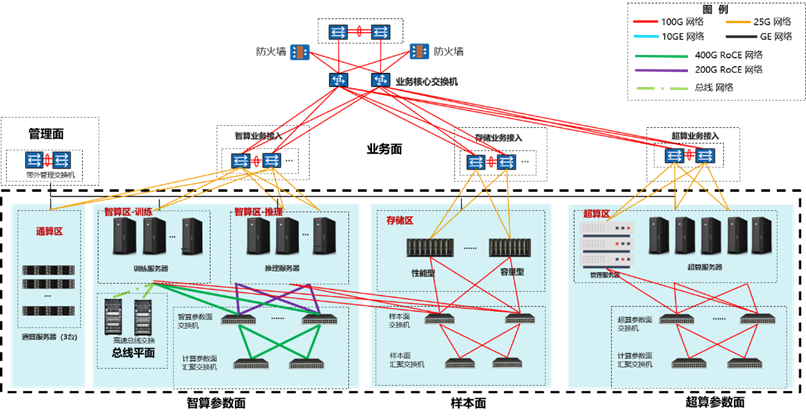
平台划分四大逻辑网络平面,不同业务流量相互隔离,保障各类业务稳定运行。
1. 参数面:基于高速无损 RDMA 网络构建,主要承担 HPC 集群内部 MPI 集合通信、AI 集群多机多卡之间参数同步梯度规约流量,满足大规模并行仿真、分布式训练对于低时延高带宽的核心要求。一般依托100G/200G/400G RoCE 无损高速互联网络,保障集群内节点之间高效数据交互的关键平面。
2. 样本面:存储业务专用高速网络,承担计算节点与分布式存储之间海量数据集读写、仿真轨迹文件读写业务,保障大流量数据存取性能。为了保证存储数据的高速读写和传输,样本面可能采用了高带宽、低延迟的100G/200G ROCE等网络技术。
3. 业务面:以太网业务访问平面,用于用户业务访问任务指令下发,通过边界安全防护设备实现算力中心与外部网络的安全隔离。一般采用10G/25G IP 网络保证业务数据传输速率。
4. 管理面:包含操作系统带内管理以及硬件 BMC 带外管理两套能力,实现服务器存储交换机等全部硬件设备的远程运维、状态监控故障告警。通过1G以太网链路连接到所有计算节点和存储节点,构建统一的管理网络,管理员可以对所有计算节点进行远程管理、监控和故障排除。
建设国产 CPU 并行 HPC 集群,由多台计算节点搭配双机热备的管理节点共同组成。集群部署国产操作系统、并行通信库、全套数学基础库,完成主流仿真软件在国产硬件架构下的源码编译、性能优化适配,保证原有仿真业务可以平滑迁移运行。
依托统一算力调度平台实现作业全生命周期管理,支持串行任务单机 OpenMP 并行任务跨节点 MPI 并行任务的排队调度,可以按照课题组科研项目设置资源配额任务优先级。平台具备完整集群监控能力,实时采集 CPU 内存磁盘 IO 网络带宽等硬件指标,出现异常及时告警。系统针对长周期仿真任务提供断点续算故障节点自动迁移快照保存功能,当部分硬件出现故障时任务自动调度至健康节点继续运行,避免长时间仿真任务全部作废。
智算区整合推理算力与大规模训练算力,全部资源统一纳入算力调度平台管控。推理算力主要承担科研大模型在线交互式推理、高通量分子批量预测、小规模模型 LoRA 微调业务;训练算力聚焦支撑中大型科研专用大模型、材料基础模型的多机多卡分布式训练。
集群配置高速互联 RDMA 网络,部署国产操作系统、容器虚拟化平台、分布式通信组件、国产 AI 训练推理框架以及材料领域模型适配工具包。系统完整支持数据并行模型并行流水线并行多种分布式训练策略,提供梯度累积模型分片分布式快照保存等训练优化能力,实现长周期训练任务断点续训。
调度平台完成训推任务统一编排调度,实现算力潮汐互通,训练集群空闲算力可以承接推理与微调任务,推理集群闲置资源可以用于小规模模型迭代,硬件异常显存溢出网络拥塞均可自动告警,完整记录模型部署任务提交数据集上传下载全部操作日志,满足安全审计要求。
通算区部署多台通用业务服务器,作为平台业务载体,承载 Web 门户界面、数据治理后台服务、仿真管理服务、各类开发工具以及中间件组件,为上层 HPC 仿真、AI 训推业务提供稳定的应用运行支撑环境。服务器采用容器化部署模式,便于后续业务模块的迭代升级,同时支持横向扩展,当业务访问量提升时,可以通过增加节点数量提升整体服务承载能力。
存储区采用冷热分离两套分布式存储设备,组成统一存储资源池。高性能并行存储作为热数据主存储,专门承载仿真临时波函数文件分子动力学轨迹、模型权重文件、训练中间快照、在线推理缓存等高频读写业务,满足高 IOPS 低时延的访问诉求。大容量归档存储用于存放仿真完成的结果文件、各类试验谱图图像、历史分子数据集、归档模型文件等访问频次较低的温冷数据,兼顾大容量存储需求与建设成本。
所有存储节点配置相互独立的管理平面与业务高速平面,系统配置自动化数据迁移引擎,依据文件访问频次和生命周期,自动完成热温冷数据流转,保障计算业务连续性。
1) 热数据留存规则:仿真运行中临时文件、正在训练的数据集、在线推理 KV 缓存常驻高性能存储;任务运行期间禁止自动迁移,保障计算连续性。
2) 热转温迁移规则:仿真任务结束、模型训练迭代完成后,超过7天未频繁访问的仿真结果、中间模型快照自动迁移至大容量存储温分区。
3) 温转冷归档规则:超过 180 天无读取操作的历史仿真工程、过期科研数据集、竣工型号资料自动归档至大容量存储冷分区。
算力调度平台是整套超智算中心的核心控制中枢,完成 HPC CPU 算力 AI 推理算力 AI 训练算力的统一抽象池化管理。平台通过部署在各个计算节点上的代理程序完成硬件资源自动发现注册,对异构硬件资源进行抽象标准化,屏蔽底层硬件架构差异,对外输出统一的逻辑算力单元。平台支持容器化以及硬件辅助虚拟化技术,实现算力资源细粒度切分与隔离。
调度器具备拓扑感知负载均衡任务抢占多队列优先级管理能力,支持在线业务与离线批处理任务混合部署。平台实现全景式资源监控,采集硬件状态作业运行全维度指标,具备资源碎片整理任务自动回收等优化能力,持续提升集群整体资源利用率。平台内置完善的多租户管理体系,逻辑隔离与物理隔离手段相结合,依托角色权限体系实现细粒度访问控制。平台提供资源计量计费统计、可视化运营监控门户,方便管理人员掌握集群整体运行状态,也可以让科研用户查看自身项目资源消耗情况。
数据治理平台实现科研数据全生命周期管理,和算力调度平台双向打通,形成完整业务闭环。平台内置多源异构数据接入集成模块,支持批量数据导入以及流式数据实时采集,适配不同来源不同格式的科研数据。平台集成自动化数据探查画像、灵活可配置的数据清洗规则引擎、标准化数据质量评估体系,完成原始科研数据的治理加工。平台配备交互式协同标注工具,结合主动学习智能预标注数据增强合成能力,高效产出高质量 AI 训练数据集。同时平台提供元数据管理数据血缘追踪数据资产目录等模块,实现全部科研数据资产的可查可管可用。治理完成后的标准化数据集可以直接供给 HPC 仿真、AI 训练推理业务使用;而仿真输出、AI 训练产出的数据集与模型文件也可以回写到数据治理平台,完成沉淀归档,为后续科研项目复用提供支撑。
平台从网络、主机、算力平台、数据四个维度构建多层安全防护体系。网络层面严格区分业务平面与管理平面,实现流量隔离,网络边界部署安全防护设施抵御外部风险。主机层面统一进行基线加固,关闭不必要服务端口。算力平台层面落实多租户隔离策略,区分普通项目与涉密项目资源,基于角色完成细粒度权限管控。数据层面落实传输加密存储加密,针对敏感科研数据实现脱敏处理,所有访问操作日志完整留存,满足科研保密审计相关规范。
本超智算中心采用全栈国产化的整体设计思路,深度融合 HPC 高性能仿真与 AI 智算两大核心能力,实现仿真训练推理数据加工一体化完整业务能力。整体架构预留充足扩展能力,能够适配科研院所新材料新工艺方向的各类科研创新业务,真正实现科研算力的自主可控,大幅降低科研人员重复性事务工作,有效提升整体科研研发效率。


 沪公网安备31011502002642号

